

فهرست مطالب
- Qwen-Audio-3.1 مجموعهای پنجمدلی برای تشخیص، تولید و تعامل بلادرنگ صوتی است.
- مدل Realtime از طریق API در QwenCloud عرضه شده و وزنهای باز ندارد.
- مدل اصلی از فراخوانی ابزار، جستوجوی وب و پنجرهٔ متنی ۲۶۲ هزار توکنی پشتیبانی میکند.
- برخی معیارهای تشخیص گفتار و مدیریت مکالمه بهتر شدهاند، اما تأخیر توقف پس از قطعکردن صحبت همچنان بالاست.
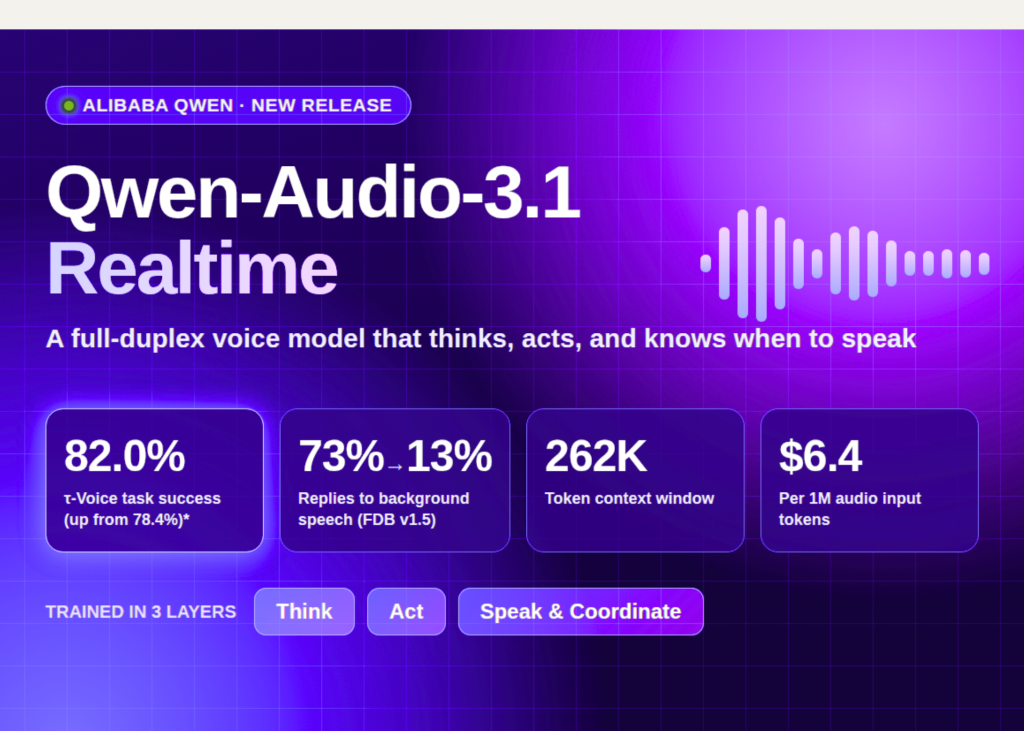
تیم Qwen شرکت Alibaba مدلهای صوتی Qwen-Audio-3.1 را عرضه کرده است؛ مجموعهای پنجمدلی برای تشخیص گفتار، تولید صدا و تعامل بلادرنگ که محور اصلی آن Qwen-Audio-3.1-Realtime است. این مدل تمامدوطرفه برای دستیارهای صوتی طراحی شده تا بتوانند همزمان به مکالمه گوش دهند، دربارهٔ زمان پاسخدادن تصمیم بگیرند و در صورت نیاز ابزارهایی مانند جستوجوی وب را به کار بگیرند. عرضهٔ فعلی از طریق API مدیریتشدهٔ QwenCloud انجام میشود و Alibaba وزنهای باز مدل را منتشر نکرده است.
بر اساس اطلاعات صفحهٔ محصول و گزارش MarkTechPost، همزمان با معرفی این مجموعه، قیمت برخی خدمات صوتی Qwen نیز کاهش یافته است: حدود ۸۵ درصد برای Realtime، حدود ۷۰ درصد برای تبدیل متن به گفتار و تا ۹۵ درصد برای تشخیص گفتار. مدل Realtime در QwenCloud با نام qwen-audio-3.1-realtime-plus و از طریق WebSocket در دسترس است؛ روشی برای ارتباط پیوسته میان برنامه و سرویس، که برای تبادل زندهٔ صوت کاربرد دارد.
مدلی که هم گوش میدهد و هم نوبت صحبت را مدیریت میکند
بسیاری از سامانههای صوتی مکالمه را به نوبتهای جداگانه تقسیم میکنند: کاربر صحبت میکند، سامانه منتظر میماند و بعد پاسخ میدهد. Qwen-Audio-3.1-Realtime برای کار در حالت تمامدوطرفه ساخته شده است؛ یعنی در جریان تعامل، تصمیم میگیرد به شنیدن ادامه دهد، صحبت کند، مکث کند یا پس از وقفه دوباره پاسخ را از سر بگیرد. این قابلیت برای عاملهای صوتی، دستیارهایی که میتوانند کار انجام دهند، اهمیت دارد؛ زیرا پاسخگویی آنها فقط به تولید یک جمله محدود نیست و گاهی باید درخواست را به ابزار بسپارند.
ساختار توصیفشده برای سامانه از دو مدل با طراحی مشترک رمزگذار صوتی و مدل زبانی تشکیل شده است. یک مدلِ تصمیمگیر تعیین میکند سامانه در هر لحظه گوش بدهد یا صحبت کند؛ مدل دیگر محتوای پاسخ را به شکل متن میسازد. سپس یک بخش تولید صدا، با توجه به متن، سابقهٔ گفتوگو، نشانههای صوتی و بافت آکوستیکی، گفتار را بهصورت جریانی تولید میکند. بهبیان ساده، سیستم باید هم دربارهٔ «چه بگوید» تصمیم بگیرد و هم «چه زمانی و با چه صدایی» آن را بیان کند.
صفحهٔ QwenCloud برای مدل Realtime ورودی و خروجی متنی و صوتی، پنجرهٔ زمینهٔ ۲۶۲ هزار توکنی، حداکثر ۲۴۵ هزار توکن ورودی و ۱۶ هزار توکن خروجی اعلام میکند. توکن واحدی است که مدلها متن و داده را به آن تقسیم میکنند. سقف پیشفرض سرویس نیز ۶۰ درخواست و ۱۰۰ هزار توکن در دقیقه ذکر شده است. قابلیتهای اعلامشده شامل فراخوانی تابع یا ابزار، جستوجوی وب، خروجی ساختاریافته، ذخیرهٔ زمینه برای استفادهٔ مجدد و تنظیم دقیق مدل است.
آموزش برای فکرکردن، عملکردن و صحبتکردن
تیم Qwen فرایند آموزش را در سه لایه شرح داده است: «فکر»، «عمل» و «صحبت و هماهنگی». در لایهٔ فکر، آموزش با دادههای جفتشدهٔ متن و صوت انجام میشود تا مدل صوتی با مدل زبانی متنیِ مبنای خود هماهنگ بماند. سپس از روشی به نام تقطیر برونسیاست استفاده میشود: معلمهای متنی و صوتی، مسیر تولیدی را که خود مدل طی کرده ارزیابی میکنند، نه اینکه مدل فقط پاسخهای ازپیشنوشتهشده را تقلید کند. پس از آن، متخصصهایی برای حوزههایی مانند همدلی، درک نیت مکالمه و تشخیص صحنههای صوتی آموزش داده و در یک مدل قابلاستفاده ادغام میشوند.
لایهٔ عمل بر استفادهٔ درست از ابزارها متمرکز است. برای آموزش، محیطهایی شامل مجموعهای از ابزارها، پایگاه دادهٔ JSON دارای وضعیت و دستورالعملهای متنی ساخته شدهاند. وظایف میتوانند به سه نتیجه برسند: انجام یک تغییر مجاز، خودداری موجه از انجام درخواست یا شناسایی درخواستی که پشتیبانی نمیشود. ارزیابی فقط به روانبودن پاسخ وابسته نیست؛ ابتدا وضعیت نهایی بررسی میشود و سپس مجازبودن تغییرها و معیارهای رفتاری سنجیده میشود. بنابراین پاسخ خوشبیان بهتنهایی نمیتواند اجرای نادرست یک کار را جبران کند.
برای پاداشدادن به رفتار مدل از GRPO استفاده شده است؛ روشی برای بهینهسازی که پاسخها را بر اساس پاداش مقایسه و تنظیم میکند. در آموزش جستوجو، تکرارهای غیرضروری جریمه میشوند. طبق گزارش منتشرشده، میانگین تعداد جستوجو در هر فراخوانی از ۴٫۳۷ به ۱٫۰۵ کاهش یافته است، هرچند امتیاز F1 تشخیص زمان مناسب برای جستوجو نیز از ۶۰٫۸۷ درصد به ۵۸٫۶۱ درصد رسیده است. این نتیجه نمونهای از بدهبستان میان کمکردن جستوجوهای اضافی و حفظ دقت در تصمیمگیری دربارهٔ زمان جستوجو است.
لایهٔ سوم به نوبتگیری و کیفیت گفتار مربوط میشود: اینکه مدل چه زمانی وارد مکالمه شود، چه زمانی سکوت کند و پس از قطعشدن صحبت چه رفتاری داشته باشد. در Full-Duplex-Bench نسخهٔ ۱٫۵، پاسخدادن به افرادی که با شخص دیگری صحبت میکنند از ۰٫۱۳ به ۰٫۰۳ کاهش یافته است. در نسخهٔ ۳٫۰ نیز نرخ استفاده از کلمات پُرکننده، مانند مکثهای لفظی، از ۰٫۷۵۹۰ به ۰٫۲۹۶۰ رسیده است. در مقابل، نرخ ازسرگیری ناخواستهٔ پاسخ پس از وقفه از ۰٫۰۳۵ به ۰٫۱۳۰ افزایش یافته است؛ نشانهای از اینکه بهبود در بعضی رفتارها لزوماً به معنی بهترشدن همهٔ جنبههای مکالمه نیست.
قیمت، معیارهای ارزیابی و محدودیتها
نرخ اعلامشده برای Qwen-Audio-3.1-Realtime برابر با ۶٫۴ دلار برای هر یک میلیون توکن ورودی صوتی و ۰٫۸ دلار برای هر یک میلیون توکن ورودی متنی است. هزینهٔ خروجی صوتی ۲۴ دلار برای هر یک میلیون توکن اعلام شده و خروجی متنی هزینه ندارد. یک مدل همراه با نام Qwen-Audio-3.1-ASR-Flash-Filetrans نیز برای رونویسی آفلاین فایلهای صوتی طولانی معرفی شده است. این مدل از واژههای سفارشی، تفکیک گویندگان، نشانهگذاری و تشخیص چندزبانه و گویشهای چینی پشتیبانی میکند. هزینهٔ آن ۰٫۱۵ دلار برای هر یک میلیون توکن ورودی و ۰٫۴۷ دلار برای هر یک میلیون توکن خروجی ذکر شده است.
در مقایسه با نسخهٔ ۳٫۰، امتیاز Audio MultiChallenge از ۴۷٫۱۲ به ۵۲٫۲۱ رسیده است. میانگین آزمون BBA در ۱۴ زبان از ۸۱٫۷ به ۸۸٫۱ درصد افزایش یافته و نرخ خطای واژه در آزمون FLEURS از ۹٫۰۱ به ۳٫۹۸ کاهش پیدا کرده است. کاهش نرخ خطای واژه یعنی سامانه در تبدیل گفتار به متن، واژههای کمتری را اشتباه تشخیص داده است. در ارزیابی تیم قرمز انسانی با ۵۰ جلسه نیز GPT-Realtime-2 با امتیاز ۹۶ درصد بالاتر از مدل Qwen با ۹۲ درصد قرار گرفته است.
برخی ارقام مربوط به τ-Voice از نسخهای سازگارشده برای گفتارِ نیمهدوطرفه به دست آمدهاند و با نتایج رسمی مدلهای تمامدوطرفه قابلمقایسه نیستند. در همان نسخهٔ سازگارشده، موفقیت انجام وظیفه از ۷۸٫۴ به ۸۲ درصد افزایش یافته است. همچنین برای حملههای چندمرحلهای، نرخ موفقیت حمله در ارزیابی گزارششده ۲۶ درصد برای چینی و ۲۳٫۵ درصد برای انگلیسی است. این ارقام باید در چارچوب روش ارزیابی همان آزمون خوانده شوند.
مقایسهٔ قیمت با سرویسهای دیگر نیز نیازمند احتیاط است. نرخهای منتشرشده برای GPT-Realtime-2 و Gemini 3.8 Live متفاوتاند، اما ارائهدهندگان صوت را به شکل یکسان به توکن تبدیل نمیکنند؛ در نتیجه هزینهٔ هر یک میلیون توکن الزاماً نشاندهندهٔ هزینهٔ برابر برای حجم مشابه صوت نیست. افزون بر این، با وجود پنجرهٔ زمینهٔ بزرگ و امکانات ابزارمحور، نبود وزنهای باز به این معناست که کاربران فعلاً برای دسترسی به نسخهٔ Realtime باید به سرویس ابری QwenCloud تکیه کنند.
این خبر برای چه کسانی اهمیت دارد
عرضهٔ Qwen-Audio-3.1 برای توسعهدهندگان دستیارهای صوتی، شرکتهایی که به رونویسی یا پاسخگویی صوتی نیاز دارند و تیمهایی که عاملهای مجهز به ابزار میسازند اهمیت دارد. ترکیب تعامل بلادرنگ، فراخوانی ابزار و جستوجوی وب میتواند ساخت برنامههای صوتی را آسانتر کند، اما کیفیت نهایی به معیارهایی فراتر از دقت متن وابسته است؛ از جمله تأخیر، تشخیص زمان مناسب برای صحبت و رفتار هنگام وقفه. کاهش قیمت اعلامشده نیز برای ارزیابی هزینهٔ استفاده مفید است، هرچند مقایسهٔ مستقیم با رقبا بهدلیل تفاوت در توکنسازی صوت محدود میماند. برای سازمانهایی که اجرای محلی یا دسترسی به وزنهای مدل را لازم دارند، منتشرنشدن وزنهای باز یک محدودیت مهم است.
پرسشهای متداول
Qwen-Audio-3.1-Realtime چیست؟
آیا میتوان مدل را روی زیرساخت شخصی اجرا کرد؟
هزینهٔ استفاده از مدل چقدر است؟
دانش آموخته مدیریت کسب و کار گرایش استراتژی و پژوهشگر ، استراتژیست و توسعه دهنده اقتصاد دیجیتال
مطالب مرتبط
 تولید محتوای چندسکویی با هوش مصنوعی | راهنمای عملیتولید محتوای چند سکویی با هوش مصنوعی به شما کمک میکند یک مقاله عمیق را به…
 سئوی هوش مصنوعی (GEO) چیست؟ راهنمای کاملسئوی هوش مصنوعی (GEO) چیست؟ راهنمای کامل سئوی هوش مصنوعی یا GEO (مخفف Generative Engine Optimization)…
 کاربرد هوش مصنوعی در تحقیق کلمات کلیدیکاربرد هوش مصنوعی در تحقیق کلمات کلیدی تحقیق کلمات کلیدی با هوش مصنوعی یعنی استفاده از…


