فهرست مطالب
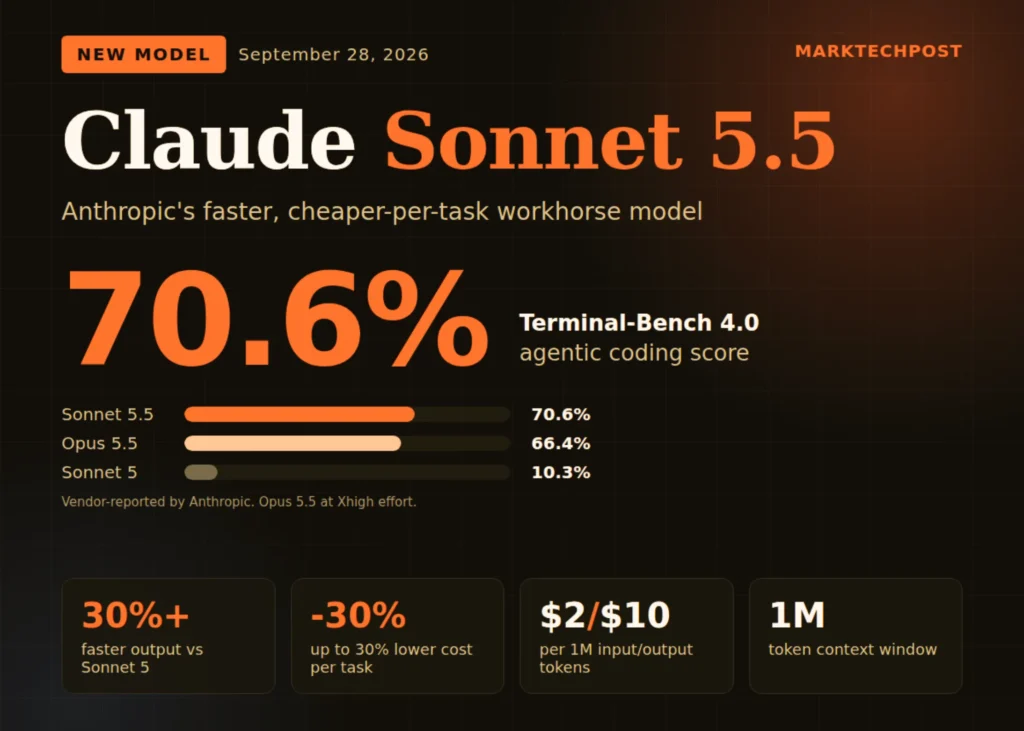
- Anthropic میگوید تولید خروجی در Sonnet 5.5 بیش از ۳۰ درصد سریعتر از Sonnet 5 است.
- قیمت فهرست API برای هر یکمیلیون توکن ورودی و خروجی بهترتیب ۲ و ۱۰ دلار است.
- این مدل در Terminal-Bench 4.0 امتیاز ۷۰٫۶ درصد گرفته؛ نتایج بنچمارکها را Anthropic اعلام کرده است.
- Sonnet 5.5 مدلی با وزنهای بسته است و امکان میزبانی مستقل آن وجود ندارد.
Anthropic مدل Claude Sonnet 5.5 را بهعنوان عضو تازه خانواده Claude 5.5 عرضه کرده است؛ مدلی که بهگفته شرکت، برای کارهای روزمره و محدود، رفع اشکال نرمافزار و تولید اسناد، ارائهها و صفحهگستردههای آماده استفاده طراحی شده است. این مدل با قیمت پایه مشابه Sonnet 5 عرضه میشود، اما Anthropic میگوید سرعت تولید خروجی آن بیش از ۳۰ درصد افزایش یافته و بهدلیل نیاز کمتر به توکن و فراخوانی ابزارها، هزینه انجام بعضی کارها میتواند تا ۳۰ درصد پایینتر باشد. در گزارش MarkTechPost، تاریخ انتشار این خبر ۲۹ سپتامبر ۲۰۲۶ ذکر شده است.
مدلی میان سرعت و تواناییهای Opus
Claude Sonnet 5.5 دومین مدل معرفیشده در خانواده Claude 5.5 است و پس از Claude Opus 5.5 به بازار آمده. Anthropic آن را گزینهای سریعتر و کمهزینهتر در کنار Opus معرفی میکند؛ مدلی که برای وظایفی مناسب است که دامنه روشنی دارند و به تواناییهای گستردهتر برای حل مسئلههای پیچیده و باز نیاز ندارند.
این مدل از طریق Claude Platform و همچنین AWS، Google Cloud و Microsoft Azure در دسترس قرار گرفته است. با این حال، Sonnet 5.5 مدلی با وزنهای بسته است؛ یعنی کاربران نمیتوانند وزنهای آن را دریافت کنند و مدل را بهصورت مستقل روی زیرساخت خود میزبانی کنند.
در مقایسه با Sonnet 5، Anthropic چهار محور اصلی بهبود را مطرح کرده است: سرعت، بهرهوری هزینه، کیفیت نوشتار و تواناییهای بینایی و کارهای طولانیمدت. شرکت میگوید Sonnet 5.5 سریعترین مدل Sonnet تا امروز است و در تولید متن بیش از ۳۰ درصد سریعتر از نسل قبلی عمل میکند. همچنین بهگفته Anthropic، استفاده کارآمدتر از توکنها و ابزارها میتواند هزینه انجام یک کار را تا ۳۰ درصد کاهش دهد؛ این ادعا به معنای کاهش قیمت رسمی هر توکن نیست.
در بخش نوشتن، شرکت از نثر شفافتر سخن گفته و اعلام کرده برخی آزمایشکنندگان اولیه مدل را همکار بهتری برای کارهای متنی دانستهاند. این ارزیابیها به Anthropic نسبت داده شدهاند و در متن گزارش، جزئیات مستقلی درباره روش سنجش کیفیت نوشتار ارائه نشده است.
مشخصات فنی و کنترل استدلال
طبق مشخصات منتشرشده، پنجره زمینه Sonnet 5.5 یکمیلیون توکن است و مدل میتواند حداکثر ۱۲۸ هزار توکن خروجی تولید کند. پنجره زمینه به حجم اطلاعاتی گفته میشود که مدل میتواند در یک نوبت پردازش کند؛ سقف خروجی نیز محدودیت طول پاسخ یا محتوای تولیدشده را مشخص میکند. تاریخ قطع دانش قابلاتکای مدل ژوئن ۲۰۲۶ اعلام شده است.
قابلیت «تفکر تطبیقی» بهطور پیشفرض فعال است. این قابلیت به مدل امکان میدهد میزان تلاش محاسباتی اختصاصیافته به پاسخ را تنظیم کند. Anthropic پنج سطح تلاش برای مدل در نظر گرفته است: کم، متوسط، زیاد، بسیار زیاد و حداکثر. مقدار پیشفرض به محل استفاده بستگی دارد: Claude Code و برنامههای Claude روی سطح متوسط تنظیم شدهاند، در حالی که Claude Platform بهطور پیشفرض از سطح زیاد استفاده میکند.
شرکت همچنین به یک نتیجه نمایشی درباره توانایی بینایی و کار طولانیمدت اشاره کرده است: بهگفته Anthropic، Sonnet 5.5 نخستین مدل Sonnet است که توانسته بازی Pokémon Red را تنها با استفاده از تصویرهای صفحه پیش ببرد. این مورد ادعای شرکت است و گزارش، جزئیات بیشتری از شرایط آزمون ارائه نمیکند.
بنچمارکها چه میگویند؟
در بنچمارک Terminal-Bench 4.0، که برای ارزیابی عملکرد در وظایف ترمینالی به کار میرود، Sonnet 5.5 امتیاز ۷۰٫۶ درصد گرفته است. Anthropic برای Sonnet 5 امتیاز ۱۰٫۳ درصد و برای Opus 5.5 در سطح تلاش بسیار زیاد امتیاز ۶۶٫۴ درصد را گزارش کرده است. این نتایج از سوی سازنده منتشر شدهاند و روششناسی آزمون، بنا بر گزارش، در System Card مدل توضیح داده شده است.
در CursorBench 4.0، امتیاز Sonnet 5.5 برابر با ۵۵٫۵ درصد اعلام شده؛ حدود دو واحد درصد کمتر از امتیاز ۵۷٫۸ درصدی Opus 5.5. در FrontierCode 1.1، مدل در سطح تلاش بسیار زیاد به ۵۲٫۱ درصد و در سطح حداکثر به ۴۶٫۲ درصد رسیده است. Anthropic برای GPT-6 Sol در همین مقایسه امتیاز ۴۹٫۳ درصد را ذکر کرده است.
فاصله میان نتیجه سطح بسیار زیاد و حداکثر در FrontierCode توضیح داده شده است. بهگفته Anthropic، مدل در سطح حداکثر بیشتر سراغ بازبینی کد چندعاملی رفته؛ فرایندی که گاهی به پایاننیافتن کار در زمان مقرر یا ویرایشهایی خارج از محدوده منجر شده است. از آنجا که این آزمون چنین مواردی را جریمه میکند، امتیاز سطح حداکثر پایینتر آمده است.
در GDPval-AA v2.1، امتیاز اعلامشده برای Sonnet 5.5 برابر با ۱۸۴۴ است؛ این رقم نزدیک به ۱۸۴۶ برای Opus 5.5 و بالاتر از ۱۴۴۹ برای Sonnet 5 است. در آزمون استفاده از رایانه OSWorld 2.1، Sonnet 5.5 امتیاز ۸۰٫۱ درصد گرفته و به امتیاز ۸۱٫۸ درصدی Opus 5.5 نزدیک شده است. در Humanity’s Last Exam نیز امتیاز مدل با استفاده از ابزارها ۶۴٫۵ درصد اعلام شده؛ در مقایسه با ۵۴٫۹ درصد برای Sonnet 5.
این امتیازها بهتنهایی تصویری کامل از عملکرد مدل در همه کاربردها نمیدهند: اعداد در خبر از سوی Anthropic گزارش شدهاند و نتیجه میتواند به روش آزمون، تنظیمات و سطح تلاش وابسته باشد. خود شرکت نیز تأکید کرده که Opus 5.5 همچنان در کارهای پیچیده و باز توانمندتر است.
قیمت ثابت، اما ادعای مصرف کمتر
قیمت فهرست API برای Sonnet 5.5 با Sonnet 5 برابر مانده است: دو دلار برای هر یکمیلیون توکن ورودی و ۱۰ دلار برای هر یکمیلیون توکن خروجی. هزینه خواندن دادههای ذخیرهشده در حافظه نهان، بهازای هر یکمیلیون توکن ۰٫۲۰ دلار و هزینه نوشتن در حافظه نهان ۲٫۵۰ دلار اعلام شده است. این نرخ پایه نصف قیمت اعلامشده برای Opus 5.5، یعنی چهار دلار برای ورودی و ۲۰ دلار برای خروجی، است.
بنابراین صرفهجویی ادعاشده از کاهش نرخ رسمی هر توکن ناشی نمیشود؛ Anthropic آن را به مصرف کمتر توکن و ابزار برای انجام کار نسبت میدهد. در نمونههایی که شرکت از مشتریان نقل کرده، Balyasny Asset Management حدود ۱۲۱ هزار توکن برای هر پاسخ با Sonnet 5.5 اندازه گرفته، در برابر ۴۹۷ هزار توکن با Sonnet 5. شرکت Base44 نیز گفته برای ساخت هر برنامه بهطور متوسط ۳٫۶ دور تکرار داشته، در حالی که این تعداد برای Opus 5 برابر ۷٫۷ بوده است. Zendesk هم پردازش ۲۰ درصد سریعتر تیکتها را گزارش کرده است. این ارقام نمونههای اعلامشده از سوی شرکتها هستند و بهتنهایی نتیجهای یکسان برای همه کاربران را تضمین نمیکنند.
این خبر برای چه کسانی اهمیت دارد
Claude Sonnet 5.5 برای توسعهدهندگانی که با اصلاح کد و ابزارهای ترمینالی کار میکنند، و نیز سازمانهایی که به تولید اسناد یا پردازش حجم زیادی از درخواستها نیاز دارند، اهمیت دارد؛ بهویژه اگر سرعت و مصرف توکن در هزینه نهایی آنها نقش داشته باشد. با این حال، انتخاب مدل باید به نوع کار و نتایج عملی همان محیط وابسته باشد: Anthropic میگوید Opus 5.5 برای وظایف پیچیده و باز همچنان گزینه قویتری است، و وزنهای بسته Sonnet 5.5 نیز آن را از سازمانهایی که اجرای مستقل مدل را لازم دارند، دور میکند.
پرسشهای متداول
قیمت Claude Sonnet 5.5 چقدر است؟
Claude Sonnet 5.5 در چه پلتفرمهایی در دسترس است؟
آیا میتوان Claude Sonnet 5.5 را روی زیرساخت شخصی اجرا کرد؟
دانش آموخته مدیریت کسب و کار گرایش استراتژی و پژوهشگر ، استراتژیست و توسعه دهنده اقتصاد دیجیتال
مطالب مرتبط
 هوش مصنوعی در سئو| راهنمای استراتژی، ابزارها و پیاده سازیهوش مصنوعی در سئو به استفاده هدفمند از مدل های زبانی، تحلیل داده، اتوماسیون و ابزارهای…
 تولید محتوای سئوشده با هوش مصنوعی| مزایا و نکات مهمتولید محتوای سئوشده با هوش مصنوعی تولید محتوای سئوشده با هوش مصنوعی، فرایند استفاده از مدلهای…
 آموزش پرامپت نویسی حرفهای؛ ۱۵ تکنیک برای گرفتن بهترین نتیجه از ChatGPT و هوش مصنوعیپرامپتنویسی حرفهای مهارت تبدیل یک نیاز مبهم به دستورالعملی روشن، زمینهدار و قابل ارزیابی برای ابزارهای…