فهرست مطالب
- MAI-Transcribe-2-Streaming از ۶۰ زبان پشتیبانی میکند و متن اولیه را کمی بیش از ۱۰۰ میلیثانیه پس از دریافت صدا ارائه میدهد.
- Microsoft AI همزمان MAI-Voice-2.1 و نسخه کمتأخیر MAI-Voice-2.1-Flash را معرفی کرده است.
- قیمت آغازین رونویسی ساعتی ۰٫۵۴ دلار اعلام شده و دو مدل صوتی بهترتیب برای هر یک میلیون نویسه ۲۲ و ۱۵ دلار هزینه دارند.
- هر سه مدل از طریق Microsoft Foundry در دسترساند و Microsoft با ابزار Chatter کارکرد ترکیبی آنها را نمایش میدهد.
مدل رونویسی مایکروسافت، MAI-Transcribe-2-Streaming، بههمراه دو مدل تولید گفتار معرفی شده است؛ مجموعهای که به گفته Microsoft AI برای ساخت عاملهای صوتی طراحی شده تا بتوانند گفتار را بشنوند، در جریان مکالمه پردازش کنند و پاسخ صوتی بدهند. مدل رونویسی از ۶۰ زبان پشتیبانی میکند و میتواند کمی بیش از ۱۰۰ میلیثانیه پس از دریافت صدا، متن اولیه را نشان دهد؛ ویژگیای که برای زیرنویس زنده و مکالمههای تعاملی اهمیت دارد.
Microsoft AI این سه مدل را در اول اکتبر ۲۰۲۶ معرفی کرد. در کنار MAI-Transcribe-2-Streaming، دو محصول MAI-Voice-2.1 و MAI-Voice-2.1-Flash قرار دارند که متن را به گفتار تبدیل میکنند. شرکت میگوید این مدلها در کنار هم یک زنجیره صوتی برای توسعهدهندگانی میسازند که عاملهای مکالمهای ایجاد میکنند؛ سامانههایی که باید بتوانند در فاصلههای کوتاه میان نوبتهای گفتوگو، صدا را دریافت و پاسخ تولید کنند.
مدل رونویسی مایکروسافت چگونه گفتار را زنده به متن تبدیل میکند؟
MAI-Transcribe-2-Streaming برای تبدیل پیوسته صدا به متن ساخته شده است. برخلاف رونویسیای که تا پایان صحبت گوینده منتظر میماند، این مدل از همان ابتدای دریافت صدا فرضیههای متنی اولیه تولید میکند. «فرضیه متنی» در اینجا نسخهای موقت از آن چیزی است که سامانه تا آن لحظه از گفتار تشخیص داده است؛ با رسیدن واژهها و اطلاعات بیشتر، متن میتواند اصلاح شود.
طبق توضیحات Microsoft، مدل کمی بیش از ۱۰۰ میلیثانیه پس از دریافت صوت، نخستین بخشهای متن را ارائه میکند. سپس با اضافهشدن زمینه، خروجی را بازبینی میکند و وقتی متن به اندازه کافی پایدار شد، آن را نهایی میکند. این فرایند بهمعنای آن است که خروجی نخست لزوماً متن نهایی نیست؛ اما میتواند به برنامهای که از مدل استفاده میکند فرصت دهد زودتر واکنش نشان دهد.
برای نمونه، یک عامل صوتی ممکن است پیش از آنکه گوینده جملهاش را تمام کند، بخشی از درخواست را تشخیص دهد و پردازش آن را آغاز کند یا ابزاری را فراخوانی کند. همچنین سامانههای زیرنویس زنده میتوانند هنگام صحبت، متن را نمایش دهند. اینها کاربردهایی هستند که شرکت برای پردازش جریانی مطرح میکند؛ یعنی دریافت و تحلیل داده در همان زمانی که به سیستم میرسد، نه پس از پایان کامل آن.
این مدل از ۶۰ زبان پشتیبانی میکند و به گفته شرکت، زبان را بهطور خودکار و پیوسته تشخیص میدهد. بنابراین توسعهدهنده میتواند قابلیت تشخیص زبان را در جریان استفاده به کار بگیرد، بدون آنکه کاربر ناچار باشد زبان را در هر مرحله بهصورت دستی انتخاب کند. منبع جزئیات بیشتری درباره نام زبانهای پشتیبانیشده یا نحوه عملکرد مدل در جابهجایی میان چند زبان در یک مکالمه ارائه نمیکند.
Microsoft میگوید در آزمونهای داخلی خود، واژهها در این مدل برای کاربردهای دیکته و زیرنویس بیدرنگ دو برابر سریعتر از نزدیکترین رقیب ظاهر شدهاند. این مقایسه را باید ادعای خود شرکت دانست: در گزارش منتشرشده، نام رقیب و جزئیات روش آزمون مشخص نشده است. در عین حال، طبق اعلام Microsoft، مدل در رتبه نخست Artificial Analysis برای دقت متنهای نهایی و جزئی قرار دارد؛ ادعایی که به ارزیابی آن مجموعه نسبت داده شده است.
قیمت آغازین MAI-Transcribe-2-Streaming برای هر ساعت صوت ۰٫۵۴ دلار اعلام شده است. این نرخ، طبق اطلاعات منتشرشده، تا پایان سال جاری میلادی برقرار خواهد بود. گزارش درباره نرخ پس از این دوره یا جزئیات سطوح مختلف استفاده توضیحی نمیدهد.
دو مدل تولید گفتار با تمرکز بر زبان و سرعت
MAI-Voice-2.1 بخش تبدیل متن به گفتار این مجموعه را پوشش میدهد. مدل از ۲۳ زبان و ۲۶ منطقه زبانی پشتیبانی میکند. Microsoft میگوید یک هویت صوتی واحد میتواند هنگام تغییر زبان حفظ شود؛ در عین حال، صدا در هر زبان با لهجه بومی و عبارتبندی محلی بیان میشود. به این ترتیب، سازندگان برنامه میتوانند صدایی ثابت را برای تجربه چندزبانه در نظر بگیرند، بهجای آنکه با هر تغییر زبان، هویت صوتی متفاوتی به کاربر ارائه شود.
شرکت برای توضیح این قابلیت به نمونههایی مانند یک برنامه آموزشی اشاره میکند که میتواند زبان تدریس را عوض کند، بیآنکه صدای معلم تغییر کند، یا دستیاری که به زبان شنیدهشده پاسخ میدهد. این مثالها کاربردهای احتمالیاند و نه گزارش از محصول مشخصی که هماکنون چنین قابلیتی را به کاربران عرضه کرده باشد. قیمت اعلامشده برای MAI-Voice-2.1 برابر با ۲۲ دلار بهازای هر یک میلیون نویسه است.
MAI-Voice-2.1-Flash نسخهای است که Microsoft برای بارهای کاری پرتعداد و حساس به تأخیر معرفی کرده است. بار کاری حساس به تأخیر، در اینجا به استفادهای اشاره دارد که سرعت پاسخ در آن اهمیت دارد؛ مانند سامانهای که باید در جریان مکالمه زنده و بدون مکث محسوس جواب صوتی تولید کند. نسخه Flash همان زبانها و امکان حفظ هویت گوینده در زبانهای مختلف را پشتیبانی میکند.
به گفته Microsoft، MAI-Voice-2.1-Flash میتواند ۴۵ ثانیه صوت را با تأخیر سرتاسری ۱۵۰ میلیثانیه تولید کند. «تأخیر سرتاسری» مدتزمان لازم از آغاز پردازش تا آمادهشدن خروجی را توصیف میکند. شرکت همچنین از استنتاج مدل ۵۵ درصد سریعتر و هزینهای حدود ۶۰ درصد کمتر از مدلهای قابلمقایسه سخن گفته است. جزئیات مدلهای مبنا یا روش محاسبه این مقایسهها در گزارش مشخص نشده است. قیمت Flash برای هر یک میلیون نویسه ۱۵ دلار اعلام شده است.
هر دو مدل تولید گفتار میتوانند با استفاده از چند ثانیه صدای مرجع، صدای یک گوینده را در زبانهای پشتیبانیشده بازسازی کنند. Microsoft میگوید تدابیر رضایت نیز برای کاهش احتمال سوءاستفاده در این قابلیت در نظر گرفته شده است. در اطلاعات منتشرشده، جزئیات فنی این تدابیر یا شیوه اجرای آنها شرح داده نشده است.
دسترسی توسعهدهندگان و جایگاه مجموعه صوتی
Microsoft میخواهد سه مدل را اجزای یک مسیر کامل برای عاملهای صوتی معرفی کند: دریافت گفتار، پردازش درخواست و استفاده از ابزارها، و در نهایت پاسخگویی با صدا. این چیدمان برای توسعهدهندهای اهمیت دارد که میخواهد سامانهاش در یک مکالمه طبیعی، از ورودی صوتی به پاسخ گفتاری برسد. با این حال، معرفی این اجزا بهتنهایی نشان نمیدهد که هر برنامهای با اتصال آنها خودکار و بدون تنظیمات تکمیلی به یک عامل کامل تبدیل میشود؛ شرکت آنها را بهعنوان ابزارهایی برای ساخت چنین تجربههایی عرضه کرده است.
طبق گزارش، هر سه مدل از طریق Microsoft Foundry، MAI Playground، Vercel و Azure Voice Live قابل دسترسیاند. دو مدل تولید گفتار از OpenRouter نیز عرضه شدهاند و پشتیبانی LiveKit قرار است بهزودی اضافه شود. راهنمای توسعهدهندگان Microsoft درباره MAI-Transcribe-2-Streaming، دسترسی از طریق یک رابط WebSocket سازگار با OpenAI Realtime یا Azure Speech SDK را نیز توضیح میدهد. در این توضیحات، یکپارچهسازی Foundry در مرحله پیشنمایش عمومی معرفی شده است.
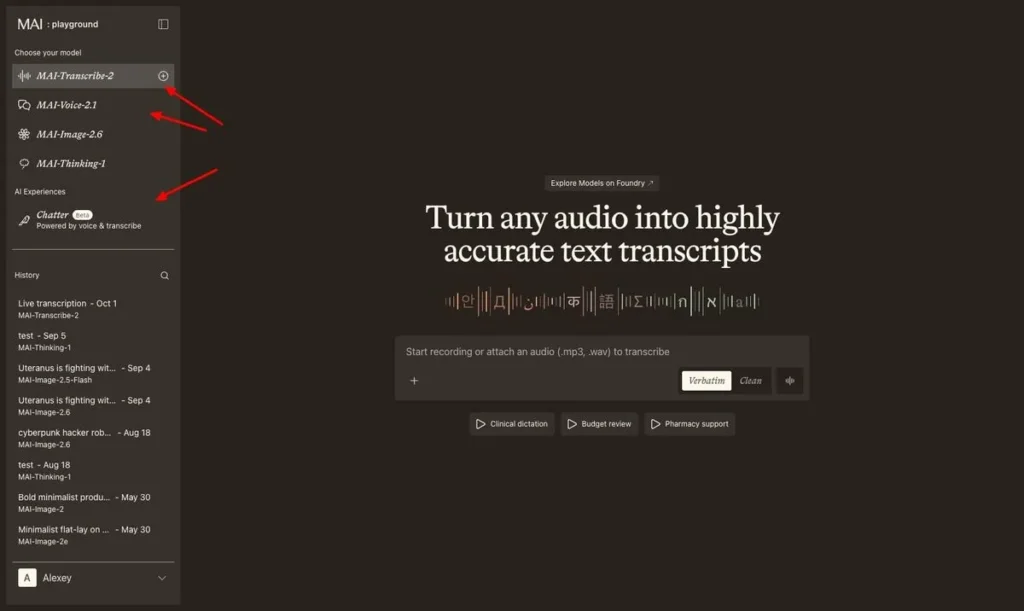
Microsoft همچنین ابزار Chatter را در MAI Playground منتشر کرده تا کارکرد مدلها در کنار یکدیگر را نشان دهد. چنین محیطی میتواند به توسعهدهندگان کمک کند پیش از طراحی یک برنامه کامل، تعامل میان تبدیل گفتار به متن و تولید پاسخ صوتی را بررسی کنند. گزارش، اطلاعاتی درباره محدودیتهای استفاده، دسترسپذیری در مناطق مختلف یا زمانبندی عرضه گستردهتر این ابزار ارائه نمیکند.
معرفی همزمان مدلهای رونویسی و تولید گفتار نشان میدهد Microsoft در این عرضه فقط بر تشخیص گفتار تمرکز نکرده است؛ هدف اعلامشده، فراهمکردن اجزای مختلف یک تعامل صوتی زنده است. معیارهای مهم برای سنجش کارایی چنین مجموعهای، از جمله دقت متن، زمان شروع خروجی، هزینه استفاده و کیفیت صدای چندزبانه، در گزارش از نگاه شرکت بیان شدهاند و کاربران و توسعهدهندگان میتوانند آنها را با نیازهای محصول خود بسنجند.
این خبر برای چه کسانی اهمیت دارد
این عرضه بیش از همه برای توسعهدهندگان عاملهای صوتی، سازندگان ابزارهای دیکته و زیرنویس زنده، و کسبوکارهایی اهمیت دارد که میخواهند در محصولات خود پاسخگویی صوتی چندزبانه ارائه کنند. تأخیر پایین در نمایش متن اولیه میتواند برای برنامههایی مفید باشد که باید پیش از پایان صحبت واکنش نشان دهند؛ در سوی دیگر، حفظ هویت صدا میان زبانها ممکن است به یکپارچگی تجربه کاربری کمک کند.
قیمتگذاری نیز برای تیمهایی که باید هزینه پردازش صوت را در مقیاسهای متفاوت بسنجند، بخشی از تصمیم است: رونویسی بر اساس ساعت صوت محاسبه میشود و تولید گفتار بر مبنای تعداد نویسهها. با این حال، ادعاهای مربوط به سرعت، رتبه دقت و صرفهجویی هزینه از سوی Microsoft مطرح شدهاند و جزئیات کافی برای ارزیابی مستقل آنها در گزارش حاضر وجود ندارد. بنابراین، برای انتخاب مدل مناسب باید علاوه بر مشخصات اعلامشده، عملکرد آن در زبانها و کاربرد واقعی هر محصول نیز بررسی شود.
پرسشهای متداول
MAI-Transcribe-2-Streaming چه کاری انجام میدهد؟
مدلهای صوتی جدید Microsoft از چند زبان پشتیبانی میکنند؟
این مدلها از چه راههایی در دسترس توسعهدهندگان هستند؟
دانش آموخته مدیریت کسب و کار گرایش استراتژی و پژوهشگر ، استراتژیست و توسعه دهنده اقتصاد دیجیتال
مطالب مرتبط
 بهترین هوش مصنوعی برای ساخت پاورپوینتبهترین هوش مصنوعی برای ساخت پاورپوینت به هدف، زبان، نوع ارائه و میزان کنترل موردنیاز شما…
 بهترین هوش مصنوعی برای تولید محتوای اینستاگرام؛معرفی ابزارهاانتخاب بهترین هوش مصنوعی برای تولید محتوای اینستاگرام به نوع خروجی موردنیاز شما بستگی دارد. در…
 چگونه با هوش مصنوعی کسب درآمد کنیم؟کسب درآمد با هوش مصنوعی زمانی پایدار است که ابزارهای AI را با یک مهارت قابلفروش،…