فهرست مطالب
- ProvenanceGuard منبع هر ادعا را جداگانه بررسی میکند و به دادهها یا آموزش دوباره مدل وابسته نیست.
- در ارزیابی اصلی، سامانه ۱۳۸ مورد از ۱۳۹ ادعای نامعتبر را شناسایی کرد.
- دقت تشخیص منبع صحیح در ادعاهای دارای منبع قابلشناسایی حدود ۸۶ درصد بود.
- در آزمونی با منابع مشابه، تشخیص منبع دقیق فقط در ۵۰٫۳ درصد موارد درست بود.
پژوهشگران Multiverse Computing در مقالهای با نام ProvenanceGuard روشی برای بررسی پاسخ عاملهای مبتنی بر MCP معرفی کردهاند که بهجای بسندهکردن به درستی یک ادعا، میسنجد پاسخ آن را به منبع درست نسبت داده است یا نه. این تمایز در عاملهایی که همزمان از چند ابزار و سند استفاده میکنند اهمیت دارد: ممکن است اطلاعاتی واقعاً در شواهد وجود داشته باشد، اما از منبعی دیگر آمده باشد. در ارزیابی این سامانه روی دادههای یک عامل پزشکی، ProvenanceGuard از ۱۳۹ ادعایی که متخصصان نامعتبر دانسته بودند، ۱۳۸ مورد را شناسایی کرد.
درستبودن ادعا کافی نیست
در مقاله، پژوهشگران این خطا را «درهمآمیختگی میان منابع» توصیف میکنند: ادعایی که در مجموعه شواهد پشتیبانی میشود، اما پاسخ آن را به منبع اشتباهی نسبت میدهد. برای نمونه، یک عامل پشتیبانی مشتری ممکن است بگوید «طبق اطلاعات حساب، این طرح ۳۰ روز مهلت بازپرداخت دارد»، درحالیکه این مهلت در سند سیاست بازپرداخت آمده و نه در سابقه حساب مشتری. اگر همه شواهد در یک مجموعه بیتمایز ادغام شوند، پاسخ ظاهراً مستند بهنظر میرسد؛ اما انتساب آن نادرست است.
به گفته نویسندگان، چنین خطایی میتواند در موقعیتهای حساس پیامد داشته باشد. در یک عامل پزشکی، برای مثال، جزئیاتی درباره داروی یک بیمار ممکن است از ابزار مرور سابقه او آمده باشد. اگر پاسخ آن را یافتهای در پژوهشهای پزشکی معرفی کند، حتی اگر خود جزئیات درست باشد، منبع نادرستی به آن نسبت داده شده است.
این مسئله با استفاده از عاملهایی که چند ابزار را بهکار میگیرند پررنگتر میشود. امتیازهای معمول وفاداری یا پشتیبانی از شواهد میتوانند نشان دهند که اطلاعاتی برای یک ادعا وجود دارد، اما لزوماً روشن نمیکنند کدام خروجی ابزار از آن پشتیبانی کرده است. ProvenanceGuard تلاش میکند این پیوند میان هر ادعا و منبعش را حفظ کند تا هم سامانه و هم بازبین انسانی بتوانند آن را بررسی کنند.
سامانه پس از تولید پاسخ وارد عمل میشود
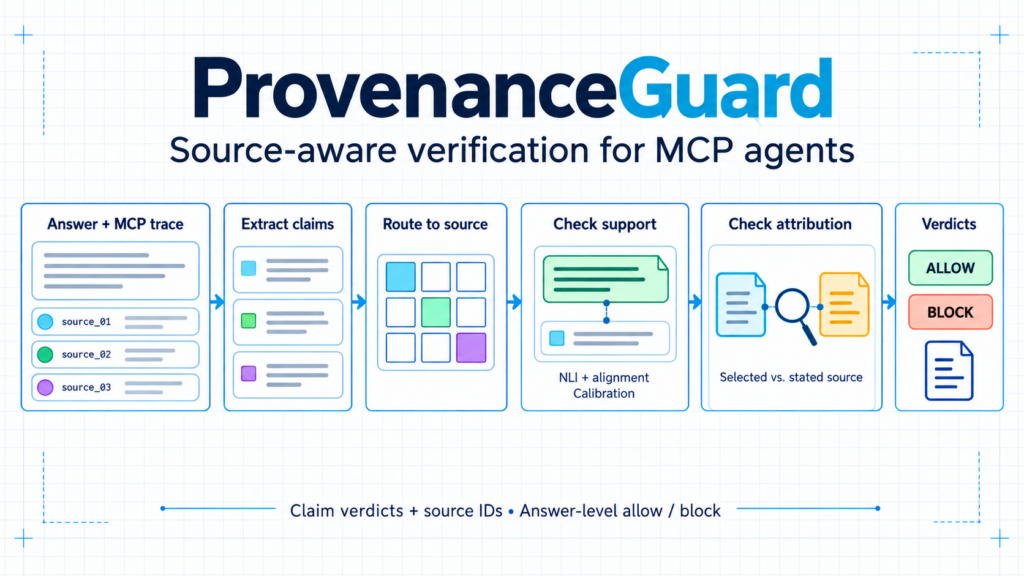
ProvenanceGuard یک لایه راستیآزمایی پس از تولید پاسخ است که روی عامل MCP قرار میگیرد. این ابزار عامل را دوباره آموزش نمیدهد و بهجای جمعکردن همه شواهد در یک متن واحد، ردپای ثبتشده تعامل عامل با ابزارها را میخواند؛ از جمله خروجی ابزارها و شناسه منبع هرکدام. سپس پاسخ را به ادعاهای مشخص تقسیم میکند، برای هر ادعا منبع مرتبط را پیدا میکند، پشتیبانی آن منبع را میسنجد و بررسی میکند که آیا پاسخ همان منبع را نام برده یا به آن اشاره کرده است.
در پایان، سامانه برای هر ادعا نتیجهای جداگانه درباره منبع ارائه میکند و برای کل پاسخ نیز تصمیم میگیرد آن را بپذیرد یا مسدود کند. این طراحی باعث میشود معلوم باشد دقیقاً کدام منبع بررسی شده و هر ادعا بر چه اساسی تأیید یا رد شده است.
در آزمایشهای گزارششده، MiniLM برای یافتن منبع مرتبط، یک مدل NLI مبتنی بر DeBERTa برای سنجش پشتیبانی و یک مدل زبانی محلی برای تقسیم پاسخ به ادعاها بهکار رفتهاند. NLI روشی برای بررسی رابطه میان دو گزاره است؛ در این کاربرد، سامانه بررسی میکند محتوای منبع از ادعای پاسخ پشتیبانی میکند یا نه. نویسندگان تأکید میکنند این مدلها بخشی از پیکربندی آزمایش بودهاند و الزام ثابت ProvenanceGuard نیستند. استفاده از مدلهای میزبانیشده نیز ممکن است، اما هر پیکربندی تازه باید جداگانه ارزیابی و کالیبره شود.
این بررسی فقط به معقولبودن جمله بسنده نمیکند. سامانه مقدارهای مشخصی مانند عدد، تاریخ یا شناسه را هم کنترل میکند؛ اگر چنین جزئیاتی در منبع نباشند، صرفاً به این دلیل که جمله باورپذیر بهنظر میرسد تأیید نمیشوند. پس از ترکیب نشانهها، یک مرحله تصمیمگیری کالیبرهشده پاسخ را ارزیابی میکند. سیاست آزمایششده محافظهکارانه است: در موقعیتهای حساس، ارجاع برخی ادعاهای پشتیبانیشده برای بررسی دوباره را به عبور ادعایی بدون پشتوانه ترجیح میدهد.
نتایج آزمایش پزشکی و منابع مشابه
پژوهشگران روش را با ردپاهای واقعی یک عامل پزشکی که از سوابق بیماران، مقالههای پژوهشی و ابزارهای دیگر استفاده کرده بود آزمودند. مجموعه بررسیشده شامل ۲۸۱ ردپا بود. برای آزمون اصلی، متخصصان ۳۶۱ ادعا از ۴۰ پاسخ را ارزیابی کردند؛ این پاسخها از دادههای استفادهشده در توسعه سامانه کنار گذاشته شده بودند.
متخصصان ۱۳۹ ادعا را نامناسب برای پذیرش دانستند. ProvenanceGuard از این موارد ۱۳۸ مورد را مسدود کرد و یک مورد از دستش دررفت. در مقابل، سامانه ۶۷ ادعایی را نیز متوقف کرد که متخصصان آنها را پشتیبانیشده ارزیابی کرده بودند. این موارد اضافه نشاندهنده رویکرد محتاطانه سامانهاند: برخی پاسخهای درست هم ممکن است برای بازبینی یا اصلاح متوقف شوند. برای ادعاهایی که منبعشان قابلشناسایی بود، سامانه در حدود ۸۶ درصد موارد منبع درست را انتخاب کرد.
در مقایسه با چهار ابزار دیگر بررسی پشتیبانی ادعا، نویسندگان میگویند ProvenanceGuard در معیار مقاله برای تشخیص ادعاهای قابلمسدودسازی و پرهیز از توقفهای غیرضروری بهترین نتیجه را بهدست آورد. تفاوت دیگر این بود که ابزارهای مقایسهشده مشخص نمیکردند هر ادعا از کدام خروجی ابزار پشتیبانی میشود؛ ProvenanceGuard این ارتباط را ثبت میکند.
بااینحال، تشخیص منبع در شرایط دشوارتر همچنان محدودیت دارد. در آزمونی جداگانه که چند منبع مشابه در اختیار سامانه بود، امتیاز F1 برای تصمیمگیری درباره مسدودکردن ادعاها ۰٫۸۴۶ بود، اما انتخاب منبع دقیق تنها در ۵۰٫۳ درصد موارد درست از آب درآمد. امتیاز F1، بهطور خلاصه، سنجهای برای ارزیابی همزمان تشخیص موارد مرتبط و کاهش خطاهای مثبت کاذب است. این نتیجه نشان میدهد جداکردن منابعی که محتوای نزدیک دارند، مسئلهای حلنشده باقی مانده است.
در آزمایشی کنترلشده نیز پژوهشگران منبعی را که در ۵۰ مورد نام برده شده بود تغییر دادند، بیآنکه شواهد پشتیبان را دستکاری کنند. سامانه هر ۵۰ انتساب جابهجاشده را شناسایی کرد. این نتیجه توانایی تشخیص خطای روشن در انتساب را نشان میدهد، اما بهتنهایی دشواری انتخاب میان چند منبع مشابه را برطرف نمیکند.
توقف پاسخ و کاربردهای بیرون از پزشکی
مسدودکردن پاسخ زمانی کاربردیتر است که راهی برای اصلاح آن وجود داشته باشد. پژوهشگران ProvenanceGuard را به یک حلقه اصلاح به سبک RARR متصل کردند تا پاسخ متوقفشده را با تکیه بر منبع بازنویسی کند یا پاسخ محتاطانهتری ارائه دهد و سپس آن را دوباره بررسی کند. در اجرای مبتنی بر ردپاهای کامل، سامانه هر ۱۷۳ پاسخ مسدودشده را تعیین تکلیف کرد؛ اما ۱۴۴ مورد به متن جایگزین یا پاسخ امتناعی رسیدند، نه بازنویسی محتوایی. بهعبارت دیگر، سامانه در این موارد ترجیح داد از پاسخ تأییدناپذیر فاصله بگیرد تا اینکه اطلاعاتی بیپشتوانه بسازد.
در اجرای تازه روی ردپاهای چندمنبعی بازسازیشده، هر ۵۹ پاسخ مسدودشده تعیین تکلیف شدند و تنها دو مورد به پاسخ جایگزین ختم شدند. طبق گزارش مقاله، سربار اجرای آفلاین روی پیکربندی محلی حدود نیمثانیه برای هر پاسخ بود؛ فراخوانیهای مربوط به NLI و انتخاب منبع نیز در حد دهها میلیثانیه زمان میبردند. این اعداد به همان پیکربندی آزمایش مربوطاند و نباید به همه مدلها یا محیطهای اجرا تعمیم داده شوند.
نویسندگان میگویند این رویکرد میتواند در هر حوزهای بهکار رود که ردپای ابزارها و شناسه منابع عامل حفظ شود. نمونهای که در متن معرفی شده، NVIDIA NVFlow است: در آن، یک مرحله اختیاری راستیآزمایی برای عامل مالی با استفاده از رویکرد منبعآگاه ProvenanceGuard ادغام شده است. این مرحله پاسخهای کاملشده را با گزیدههای SEC که عامل بازیابی کرده میسنجد و نتیجههای بررسی را جداگانه ذخیره میکند، بدون آنکه اجرای اصلی عامل یا دادههای آموزش را تغییر دهد. حلقه اصلاح شرحدادهشده در مقاله، بخشی از سامانه پژوهشی گستردهتر است و نباید با این پیادهسازی یکی گرفته شود.
ProvenanceGuard همچنین بهصورت پوستر در Agentic AI Summit 2026 در UC Berkeley ارائه شده است. اهمیت اصلی این کار، طبق توضیح پژوهشگران، فراهمکردن روشی برای بررسی عاملهای موجود و قابلردیابیکردن منبع هر ادعاست؛ نه ارائه تضمینی که هر پاسخ را بیخطا کند. نتیجه آزمون منابع مشابه نیز نشان میدهد کیفیت انتساب دقیق هنوز به بهبود نیاز دارد.
این خبر برای چه کسانی اهمیت دارد
این پژوهش برای تیمهایی اهمیت دارد که عاملهای هوش مصنوعی آنها به چند ابزار، پرونده یا پایگاه داده دسترسی دارند؛ بهویژه در حوزههایی مانند پزشکی و مالی که انتساب نادرست اطلاعات میتواند به اندازه خود اطلاعات نادرست مسئلهساز باشد. ثبت منبع هر ادعا امکان بازبینی روشنتری فراهم میکند و میتواند به تیمها کمک کند پاسخهای مشکوک را پیش از ارائه متوقف کنند.
در عین حال، نتایج مقاله نشان میدهد چنین سامانهای جای ارزیابی انسانی را نمیگیرد: ProvenanceGuard در آزمون اصلی برخی ادعاهای پشتیبانیشده را هم متوقف کرد و در انتخاب میان منابع مشابه دقت محدودی داشت. بنابراین، برای سازندگان عاملها و ناظران آنها، پیام اصلی هم فرصت است و هم هشدار: منبع پاسخ را میتوان بهشکل منظمتری بررسی کرد، اما سنجش مستقل هر پیادهسازی و توجه به خطاهای انتساب همچنان ضروری است.
پرسشهای متداول
ProvenanceGuard چه مشکلی را حل میکند؟
ProvenanceGuard چگونه پاسخها را بررسی میکند؟
مهمترین محدودیت گزارششده چیست؟
دانش آموخته مدیریت کسب و کار گرایش استراتژی و پژوهشگر ، استراتژیست و توسعه دهنده اقتصاد دیجیتال
مطالب مرتبط
 هوش مصنوعی در سئو| راهنمای استراتژی، ابزارها و پیاده سازیهوش مصنوعی در سئو به استفاده هدفمند از مدل های زبانی، تحلیل داده، اتوماسیون و ابزارهای…
 راهنمای انتخاب هوش مصنوعی برای کارخانهها در ۲۰۲۶انتخاب هوش مصنوعی برای کارخانه فقط مقایسه چند نرمافزار یا مدل زبانی نیست؛ باید مسئله کسبوکار،…
 بهترین هوش مصنوعی برای دانشجویان و تحقیقبهترین هوش مصنوعی برای دانشجویان و تحقیق، یک ابزار واحد نیست؛ انتخاب درست به مرحله پژوهش،…