


فهرست مطالب
- Julia 1 مدلی ۱۴۴٫۳ میلیونپارامتری و متنباز با مجوز Apache 2.0 است.
- این مدل برای انتخاب میان ۲ تا ۲۰ گزینه، امتیازدهی و پاسخ بله یا خیر طراحی شده است.
- مدل روی CPU اجرا میشود و نسخه ONNX آن از WebGPU در مرورگر پشتیبانی میکند.
- در آزمون Banking77، دقت Julia 1 به ۶۴ درصد رسید؛ پایینتر از مقدار مرجع Jev.
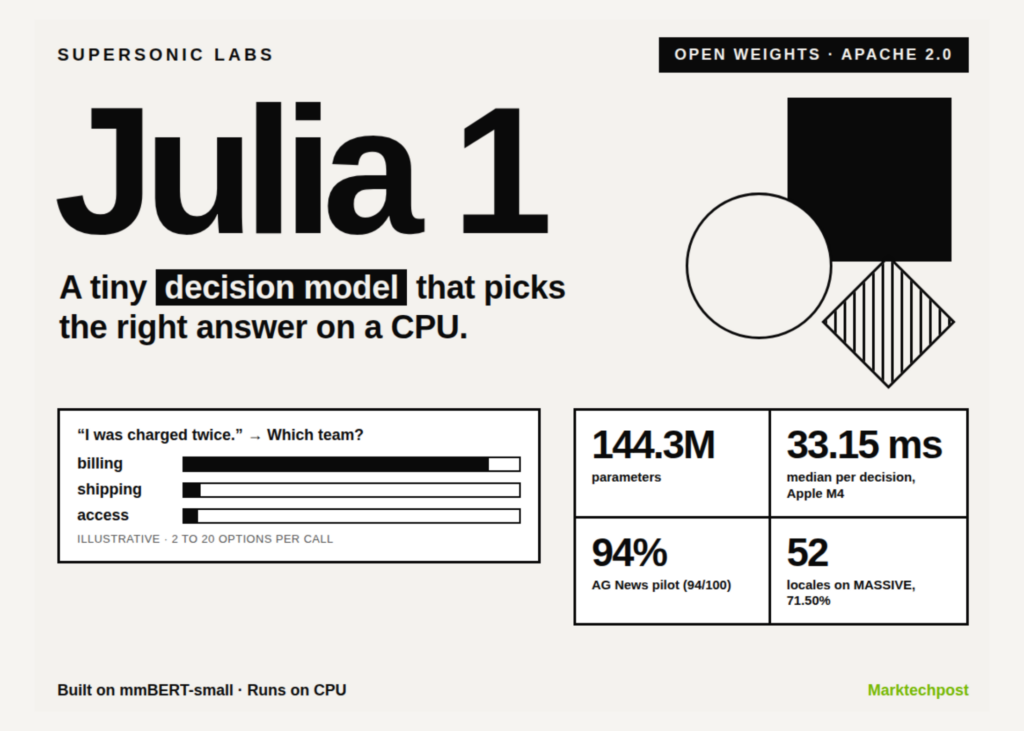
شرکت کوچک Supersonic Labs در برزیل در ۲۶ سپتامبر ۲۰۲۶ از Julia 1 رونمایی کرد؛ مدلی متنباز با ۱۴۴٫۳ میلیون پارامتر که برای انتخاب و امتیازدهی میان پاسخهای ازپیشتعیینشده ساخته شده و میتواند روی پردازنده مرکزی یا CPU اجرا شود. این مدل برخلاف چتباتها متن تولید نمیکند؛ کاربر زمینه، پرسش و مجموعهای از گزینهها را به آن میدهد و مدل یک گزینه را همراه با احتمال هر انتخاب برمیگرداند. اجرای محلی و اندازه نسبتاً کوچک، Julia 1 را به گزینهای قابل بررسی برای کاربردهایی تبدیل میکند که در آنها تصمیمگیری باید بدون اتکا به سرویس ابری انجام شود.
مدلی برای انتخاب، نه گفتوگو
به گفته Supersonic Labs، Julia 1 سه نوع وظیفه را از طریق یک رابط برنامهنویسی واحد انجام میدهد. در حالت انتخاب، از میان ۲ تا ۲۰ گزینه برچسبدار یکی را برمیگزیند؛ این قابلیت میتواند برای طبقهبندی متن یا هدایت درخواستها به بخش مناسب به کار رود. برای تعداد گزینههای بیشتر، شرکت به ابزاری به نام Router اشاره میکند که گزینهها را مرحلهبهمرحله محدود میکند.
در حالت امتیازدهی، مدل باید جایگاه مورد انتظار یک پاسخ را روی مقیاسی مرتبشده برگرداند؛ برای مثال میان سطحهای «کم»، «متوسط» و «زیاد». در حالت سوم، به یک گزاره بلهوخیری احتمال درستبودن اختصاص میدهد. خروجیها شامل احتمالهای کامل گزینهها هستند؛ یعنی فقط انتخاب نهایی ارائه نمیشود و میزان اطمینان نسبی مدل درباره گزینههای دیگر هم قابل مشاهده است. شناسههایی که فراخواننده برای گزینهها میفرستد نیز در پاسخ بدون تغییر بازگردانده میشوند.
این شیوه کار با مدلهای زبانی مولد تفاوت دارد. Julia 1 قرار نیست پاسخ آزاد بنویسد یا اطلاعات تازهای تولید کند؛ گزینهها را با توجه به متن ورودی مقایسه میکند. در نتیجه، کیفیت تصمیم آن به این وابسته است که گزینه درست در فهرست وجود داشته باشد و صورتبندی پرسش و پاسخها با کاربرد موردنظر سازگار باشد.
ساختار فنی، مجوز و هزینه آموزش
Julia 1 بر پایه mmBERT-small ساخته شده است؛ یک مدل رمزگذار چندزبانه با حدود ۱۴۰ میلیون پارامتر که بهگفته منبع، از سوی JHU CLSP برای پشتیبانی از بیش از ۱٬۸۰۰ زبان آموزش دیده است. رمزگذار بخشی از مدل است که متن ورودی را به بازنماییهای قابل پردازش تبدیل میکند. Supersonic Labs این پایه و توکنساز آن را حفظ کرده، یک بخش اختصاصی برای تصمیمگیری به آن افزوده و مدل را با نمونههای قالببندیشده برای تصمیم آموزش داده است. شرکت تأکید کرده که Julia 1 نسخه تنظیمشدهای از Qwen نیست.
وزنهای مدل با مجوز Apache 2.0 در Hugging Face منتشر شدهاند و طبق اعلام شرکت، اجرای محلی با Python 3.11 یا نسخههای جدیدتر روی CPU امکانپذیر است؛ برای پردازنده گرافیکی نیز پشتیبانی از قالب BF16 ذکر شده است. نسخه ONNX هم میتواند با WebGPU در مرورگر اجرا شود. ONNX قالبی برای جابهجایی و اجرای مدلهای یادگیری ماشین در محیطهای گوناگون است و WebGPU دسترسی برنامههای وب به توان پردازشی دستگاه را فراهم میکند. سرویس API میزبانیشده اعلام شده، اما هنوز در دسترس عموم نیست.
شرکت سقف ورودی و زمینه قابل پردازش مدل را در مجموع ۸٬۱۹۲ توکن اعلام کرده است. بااینحال، آزمونهای منتشرشده با محدودیت ۱٬۰۲۴ توکن اجرا شدهاند؛ تفاوتی که هنگام مقایسه عملکرد اعلامشده با استفاده واقعی اهمیت دارد. حجم وزنهای FP32 مدل ۵۵۰٫۵ مگابایت است. Supersonic Labs همچنین گفته هزینه GPU ابری برای آموزش و آزمایشها در مجموع حدود ۵۴۰ رئال برزیل، معادل ۱۰۴٫۰۸ دلار آمریکا، بوده است. خط لوله خصوصی آموزش منتشر نشده و شرکت میگوید Julia 2، با معماری پایهای که خودش توسعه میدهد، در دست ساخت است.
نتایج آزمونها؛ عملکرد ناهمگون
ارزیابی منتشرشده برای Julia 1 در ۲۴ سپتامبر ۲۰۲۶ روی شتابدهنده H200 با دقت BF16 و شیوه کدگذاری سختگیرانه انجام شده است. مبنای مقایسه، اعداد مرجع مدل Jev از پروتکل آزمون TypeSafe بوده، نه اجرای دوباره Jev در همان شرایط. این نکته مهم است: ارقام کنار هم قرارگرفته در گزارش لزوماً حاصل یک آزمون همزمان و کاملاً همسان نیستند.
در آزمون Typed Decisions، Julia 1 به دقت ۷۳٫۱۵ درصد رسید؛ در برابر مقدار مرجع ۷۲٫۷۰ درصد برای Jev. در آزمایش AG News با چهار برچسب، نتیجه Julia 1 برابر با ۹۴ مورد از ۱۰۰ نمونه بود، درحالیکه مقدار مرجع Jev ۹۱ درصد گزارش شده است. در آزمون DAIR Emotion با شش برچسب نیز مدل ۸۶ مورد از ۱۰۰ نمونه را درست طبقهبندی کرد؛ بالاتر از عدد مرجع ۴۸ درصد.
تصویر در Banking77 متفاوت بود. این مجموعه ۷۲ برچسب دارد و Julia 1 در آزمون محدود خود ۶۴ مورد از ۱۰۰ نمونه را درست پاسخ داد؛ درحالیکه مقدار مرجع Jev ۸۷ درصد بود. این اختلاف، روشنترین نقطه ضعف در نتایج اعلامشده است. خود شرکت نیز سازوکار Router را محدودیت احتمالی میداند: اگر گزینه درست هنگام محدودکردن مرحلهای برچسبها حذف شود، مدل دیگر نمیتواند آن را انتخاب کند. همچنین هر یک از آزمونهای آزمایشی طبقهبندی فقط ۱۰۰ نمونه داشتهاند و برای نتیجهگیری گستردهتر کافی نیستند.
در مجموعه MASSIVE که ۱۸ سناریو و ۵۲ گونه زبانی و منطقهای را در بر میگیرد، میانگین دقت کلان مدل ۷۱٫۵۰ درصد بود. نتایج گزارششده برای پرتغالی پرتغال ۸۶٫۲۵ درصد و انگلیسی ایالات متحده ۸۶٫۷۵ درصد است. اجرای CPU در ۲۵ سپتامبر بیشتر نتایج را تا حدی بازتولید کرد: ۷۲٫۵۵ درصد در Typed Decisions و ۶۰ پاسخ درست از ۱۰۰ نمونه Banking77، همراه با سه مورد امتناع از پاسخ.
سرعت اجرا و محدودیتهای استفاده
اندازهگیریهای منتشرشده نشان میدهد تأخیر اجرا به دستگاه و نوع وظیفه بستگی دارد. روی Apple M4، زمان میانه برای هر تصمیم ۳۳٫۱۵ میلیثانیه بود. روی تبلت Samsung SM-X510 با ONNX Runtime، میانه زمان ۲۰۳ میلیثانیه و بیشترین حافظه مصرفی ۳۹۳٫۱ مگابایت گزارش شد. روی Intel Core i5-1235U، تصمیمگیری در AG News میانهای برابر با ۱۰۷٫۸۳ میلیثانیه داشت.
در Banking77، زمان میانه روی همین پردازنده به ۳٬۷۱۳٫۵۴ میلیثانیه رسید. گزارش علت را استفاده از فرایند محدودکردن اولیه ۷۲ برچسب میداند؛ نمونهای از اینکه تعداد گزینهها و سازوکار Router میتواند بر سرعت اثر بگذارد. Supersonic Labs در شبکه اجتماعی X ادعا کرده Julia 1 روی لپتاپ مجهز به i5 پنج برابر سریعتر از Jev است، اما این مقایسه را باید با احتیاط دید: آزمون آزمایشی Jev یک سرویس میزبانیشده را از فرانسه فراخوانی کرده است و بنابراین تأخیر شبکه و شرایط اجرا با اجرای محلی Julia 1 یکسان نیست.
این مدل جایگزین عمومی برای توانایی استدلال یا مدلهای زبانی همهمنظوره نیست. طبق محدودیتهایی که در گزارش آمده، نمیتوان برای یافتن اطلاعات غایب، انجام جبر یا محاسبات چندمرحلهای روی آن حساب کرد. همچنین Julia 1 یک خط لوله آماده و سازگار با Transformers نیست و در حال حاضر ارائهدهنده استنتاج Hugging Face آن را میزبانی نمیکند. Supersonic Labs توصیه کرده کاربران عملکرد مدل را با پرسشهای واقعی خود بسنجند و در تصمیمهای پیامددار، نظارت انسانی را حفظ کنند. API پولی آینده نیز با قیمت برنامهریزیشده ۰٫۰۲۵ دلار بهازای هر یک میلیون توکن معرفی شده، اما هنوز فعال نیست.
این خبر برای چه کسانی اهمیت دارد
Julia 1 بیش از همه برای توسعهدهندگانی اهمیت دارد که به طبقهبندی یا مسیردهی درخواستها نیاز دارند و میخواهند مدل را روی دستگاه خود، بدون وابستگی دائمی به سرویس ابری، اجرا کنند. پژوهشگران و تیمهای فنی نیز میتوانند مجوز Apache 2.0 و نسخه ONNX را برای آزمایش و ادغام در محیطهای محلی بررسی کنند. بااینحال، نتایج محدود آزمونها، عملکرد ضعیفتر در Banking77 و تفاوت شرایط مقایسه با Jev نشان میدهد پیش از استفاده عملی باید ارزیابی مستقل و متناسب با دادههای هر کاربرد انجام شود. برای تصمیمهایی که پیامد جدی دارند، خروجی مدل بهتنهایی مبنای کافی نیست.
پرسشهای متداول
Julia 1 چه کاری انجام میدهد؟
آیا Julia 1 روی کامپیوترهای معمولی اجرا میشود؟
آیا Julia 1 برای همه وظایف طبقهبندی مناسب است؟
دانش آموخته مدیریت کسب و کار گرایش استراتژی و پژوهشگر ، استراتژیست و توسعه دهنده اقتصاد دیجیتال
مطالب مرتبط
 استفاده از هوش مصنوعی برای طراحی صفحات فرود پربازدهاستفاده از هوش مصنوعی برای طراحی صفحات فرود پربازده به معنای بهکارگیری الگوریتمهای یادگیری ماشین، پردازش…
 آیا هوش مصنوعی جایگزین متخصص تبلیغات آنلاین میشود؟هوش مصنوعی بسیاری از کارهای تکراری و تحلیلی تبلیغات آنلاین را سریعتر انجام میدهد، اما بهتنهایی…
 کاربرد هوش مصنوعی در طراحی سایتکاربرد هوش مصنوعی در طراحی سایت به استفاده از الگوریتمها و مدلهای هوشمند برای خودکارسازی و…


